Wenn Sie ein KI-Rollenspiel-Tool für den Vertrieb auswählen, machen Sie vor allem anderen einen einzigen Test. Geben Sie dem simulierten Käufer ein Ziel, das die verkaufende Person nicht kennt, und schauen Sie, ob er es hält, sobald sie vom Skript abweicht. Ein Käufer, der sein Budget, seine Unterschriftsgrenze und seine konkurrierende Priorität unter Druck behält, ist Übung. Ein Käufer, der beantwortet, was man ihn fragt, auf Nachfrage seine Schmerzpunkte ausbreitet und jede Sitzung im Abschluss enden lässt, ist ein Chatbot mit Vertriebsanstrich. Fast alles andere auf einer Funktionsliste folgt aus diesem einen Verhalten.
Danach ordnen Sie den Werkzeugtyp Ihrer Situation zu, statt aus einer Rangliste zu wählen. Teams, die neue Leute in Kohorten einarbeiten, holen am meisten aus einer eigenständigen Sprach-Rollenspiel-Plattform. Teams, die ihr Enablement bereits in einer Suite betreiben, fahren meistens besser mit dem Rollenspiel-Modul, das sie längst bezahlt haben. Zertifizierung und Auswahlverfahren gehören auf eine Assessment-Plattform, und das verändert Ihre Compliance-Lage in dem Moment, in dem eine Bewertung eine Personalentscheidung erreicht. Wer die Übung und das echte Gespräch auf demselben Satz Skripte will, ist der Fall, für den wir CallPrompter gebaut haben: Der Übungsmodus läuft mit demselben Prompter-Overlay wie ein Live-Gespräch, auf denselben Skripten.
Das Wichtigste in Kürze
- Das entscheidende Kriterium ist der Eigenwille des Käufers: ob der simulierte Käufer seine verdeckte Agenda hält, wenn die verkaufende Person vom Skript abweicht, ihm schmeichelt oder auf ein Zugeständnis drängt, das sie sich nicht verdient hat.
- Gefälligkeit ist in Sprachmodellen ein Gegner der Übung, und sie ist messbar. Über 13 an der ACL 2026 geprüfte Rollenspiel-Modelle hinweg zeigten neun signifikante positive Zusammenhänge zwischen der Verträglichkeit der Persona und Gefälligkeitsverhalten, mit einem maximalen Pearson-r von 0,87.
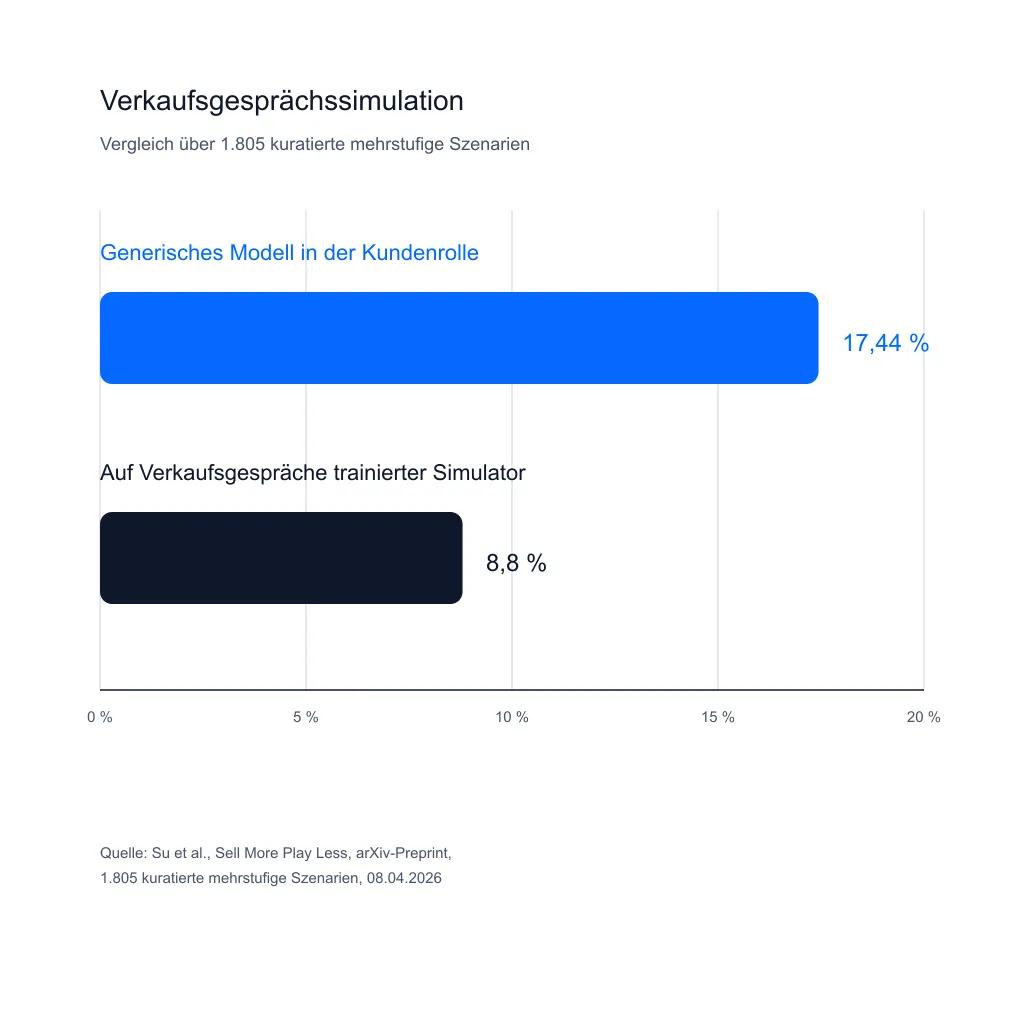
- Der Simulator entscheidet, wer gut aussieht. In einem Vertriebs-Benchmark von 2026 trat Rollenumkehr in 17,44 Prozent der Dialoge mit einem generischen Modell in der Kundenrolle auf, gegenüber 8,8 Prozent bei einem spezialisierten Simulator.
- Setzen Sie die Erwartung tief an. Die direkteste Feldevidenz zu KI-Rollenspiel berichtet einen durchschnittlichen Leistungseffekt von rund 2 Prozent, mit grösseren Zuwächsen bei zuvor schwächeren Personen.
- Die viral zitierten Behaltensquoten der Kategorie sind unbelegt. Die Behauptung von 75 gegenüber 5 Prozent stammt aus der Lernpyramide, und die Organisation, der sie üblicherweise zugeschrieben wird, teilte mit, sie könne keine Forschung zu diesen Zahlen finden.
- Eine veröffentlichte Latenzzahl bedeutet nichts, solange der Anbieter das gemessene Intervall nicht benennt. Erkennungslatenz, Antwortverzögerung nach Sprechende und Mund-zu-Ohr-Laufzeit sind drei verschiedene Dinge.
- Eine Stunde Test, bewertet über sieben gewichtete Punkte, sagt Ihnen mehr als ein Funktionsvergleich. Eigenwille des Käufers und Aussagekraft der Bewertung tragen zusammen 45 Prozent des Gesamtgewichts.
Was wir verkaufen, und warum Sie diesen Test auch auf uns anwenden sollten
CallPrompter verkauft ein Werkzeug in dieser Kategorie. Behandeln Sie diesen Leitfaden als von einer interessierten Partei geschrieben und prüfen Sie ihn entsprechend. Daraus folgen drei Dinge.
Wir nennen kein anderes Produkt. Unsere Inhaltsrichtlinie erlaubt uns nicht, die Plattformen zu bewerten, zu empfehlen oder zu verlinken, die eine Käuferin hier erwarten würde, und nur die Handvoll zu nennen, die ausserhalb dieser Richtlinie liegt, würde den Markt stärker verzerren als gar keine zu nennen. Der Vergleich weiter unten ist nach Werkzeugtyp geordnet, mit unserem eigenen Produkt als einziger namentlich genannter Zeile.
Wir veröffentlichen den Test statt des Urteils. Das Protokoll weiter unten ist das, was wir uns wünschen würden, wenn wir kaufen müssten, und es funktioniert bei jedem Produkt der Kategorie, unserem eingeschlossen.
Und wir sagen Ihnen, wo wir verlieren, in einem Abschnitt, der die Fähigkeit benennt, die wir nicht haben.
Drei verschiedene Produkte laufen unter «KI-Sales-Coaching»
Drei nicht verwandte Produkte teilen sich diesen Begriff, und quer über sie hinweg zu vergleichen ist der schnellste Weg, das falsche zu kaufen.
- Analyse nach dem Gespräch zeichnet das Gespräch auf oder tritt ihm bei und liefert danach eine Auswertung: Redeanteile, behandelte Themen, Coaching-Notizen für die Führung.
- Rollenspiel-Übung, im Markt auch «Sales-Rollenspiel» genannt, stellt die verkaufende Person in ein simuliertes Gespräch mit einem KI-Käufer, bevor ein echtes Gegenüber im Spiel ist. Um dieses Produkt geht es in diesem Leitfaden.
- Live-Coaching zeigt der verkaufenden Person Hinweise während des echten Gesprächs, solange es noch läuft.
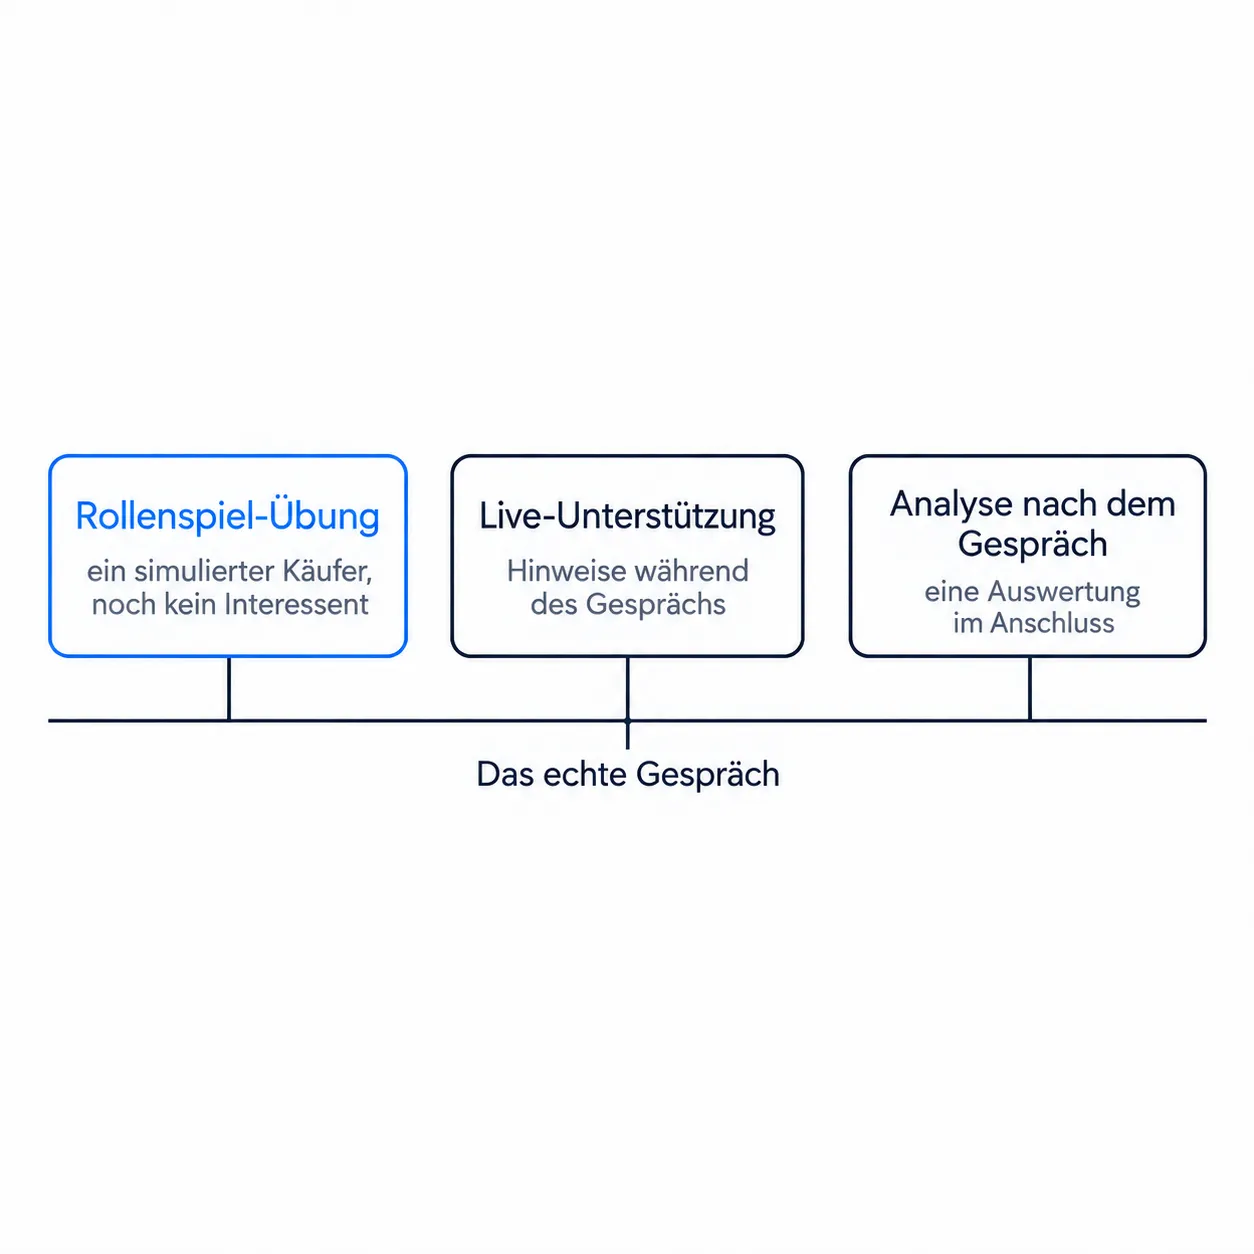
Sie lösen verschiedene Probleme und sitzen in verschiedenen Budgets. Die vollständige Unterscheidung haben wir separat in Conversation Intelligence oder Live-Coaching aufgeschrieben, deshalb hält dieser Leitfaden sie einmal fest und geht weiter.
Die eine Frage, die Übung von einem Chatbot trennt
Fragen Sie, ob der simulierte Käufer eine eigene Agenda hat und ob er sie hält.
Das Versagensmuster ist gut dokumentiert. Sprachmodelle neigen dazu, die Position der Nutzerin zu spiegeln. Eine an der ICLR vorgestellte Untersuchung von fünf Assistenten fand ein Präferenzmodell, das bei einer Aufgabe zu verbreiteten Irrtümern in 95 Prozent der Fälle die gefällige Antwort der wahren vorzog, und Modelle, die ihre Antwort nach der Rückfrage «Sind Sie sicher?» in 32 bis 86 Prozent der Fälle änderten. Die ACL-Studie von 2026 über 275 Personas und 4950 Prompts fand verträglichkeitsgetriebene Gefälligkeit in neun von 13 Modellen. Ein simulierter Käufer, der auf dieser Neigung aufsetzt, belohnt alles, was Ihre Leute sagen. Ihre Leute werden dabei selbstsicher, ohne besser zu werden.
Es ist zugleich ein Messproblem. Ein Vertriebs-Benchmark von 2026 mit 1805 kuratierten mehrstufigen Szenarien fand, dass ein generisches Modell in der Kundenrolle die Rollen in 17,44 Prozent der Dialoge umkehrte, gegenüber 8,8 Prozent bei einem Simulator, der auf annotierten Verkaufsgesprächen trainiert war. Die Rangfolgen derselben Verkaufenden über verschiedene Simulator-Typen hinweg korrelierten im Englischen nur mit r = 0,24. Der Simulator, gegen den Sie üben, entscheidet, wer gut aussieht.
Unsere eigene Entwurfslogik ist enger gefasst als Realitätsnähe. Der Einwand, den Sie behandeln können, ist der, den Sie kommen sahen. Ein simulierter Käufer, der höflich wartet, bis Sie fertig sind, bringt Ihnen bei, einen Monolog zu halten, und der Moment, in dem das im echten Gespräch bricht, ist der, in dem Ihnen jemand mitten in der Nutzenargumentation ins Wort fällt. Die Unterbrechung ist genau das, was trainiert wird. Das Abweichen vom Skript ist dasselbe Argument: Wenn der Käufer nur fragt, worauf sich die verkaufende Person vorbereitet hat, übt sie Abruf und nicht Fassung.
Die brauchbare Fassung von Persona-Treue heisst stabile Bedingungen plus zulässige Veränderung. Die Position des Käufers soll sich bewegen, wenn die verkaufende Person echte Evidenz liefert, und vorher nicht. Schreiben Sie Ihr Szenario als prüfbare Invarianten, also Budget, Unterschriftskompetenz, Bedarf und Zeitpunkt, damit Sie beides auseinanderhalten können.
KI-Rollenspiel-Tools nach Typ im Vergleich
| Werkzeugtyp | Passt für | Grösste Stärke | Grösste Grenze | Preisform |
|---|---|---|---|---|
| Eigenständige Sprach-Rollenspiel-Plattform | Teams, die neue Leute in Kohorten einarbeiten | Tiefste Persona-Bibliotheken, Bewertungsraster, Auswertungen für die Führung | Die Übung sitzt in einem anderen System als alles, was im echten Gespräch hilft | Meist auf Anfrage, selten veröffentlicht |
| Rollenspiel-Modul in einer Enablement-Suite | Teams, die ihr Enablement bereits auf dieser Suite betreiben | Ein Login, eine Auswertungssicht, keine zweite Integration | Die Rollenspiel-Ebene hinkt den spezialisierten Werkzeugen meistens hinterher | Gebündelt, der Anteil für das Rollenspiel lässt sich kaum isolieren |
| Reines Text-Szenariotraining | Schriftliche Ansprache und Nachrichtentraining | Günstig und schnell aufgesetzt | Übt nicht das Sprechen unter Unterbrechung, und genau die Fähigkeit kaufen die meisten Teams | Unterste Preisstufe der Kategorie, meist im Selbstbedienungsmodell |
| Assessment-Plattform mit Zertifizierungsfokus | Zertifizierung, Auswahlverfahren, teamübergreifende Kalibrierung | Strenge Kompetenzbewertung und belastbare Raster | Überdimensioniert für ein Team, das nur üben will, und Bewertungen, die Personalentscheidungen erreichen, heben die Compliance-Hürde | Enterprise-Stufe, nur auf Anfrage |
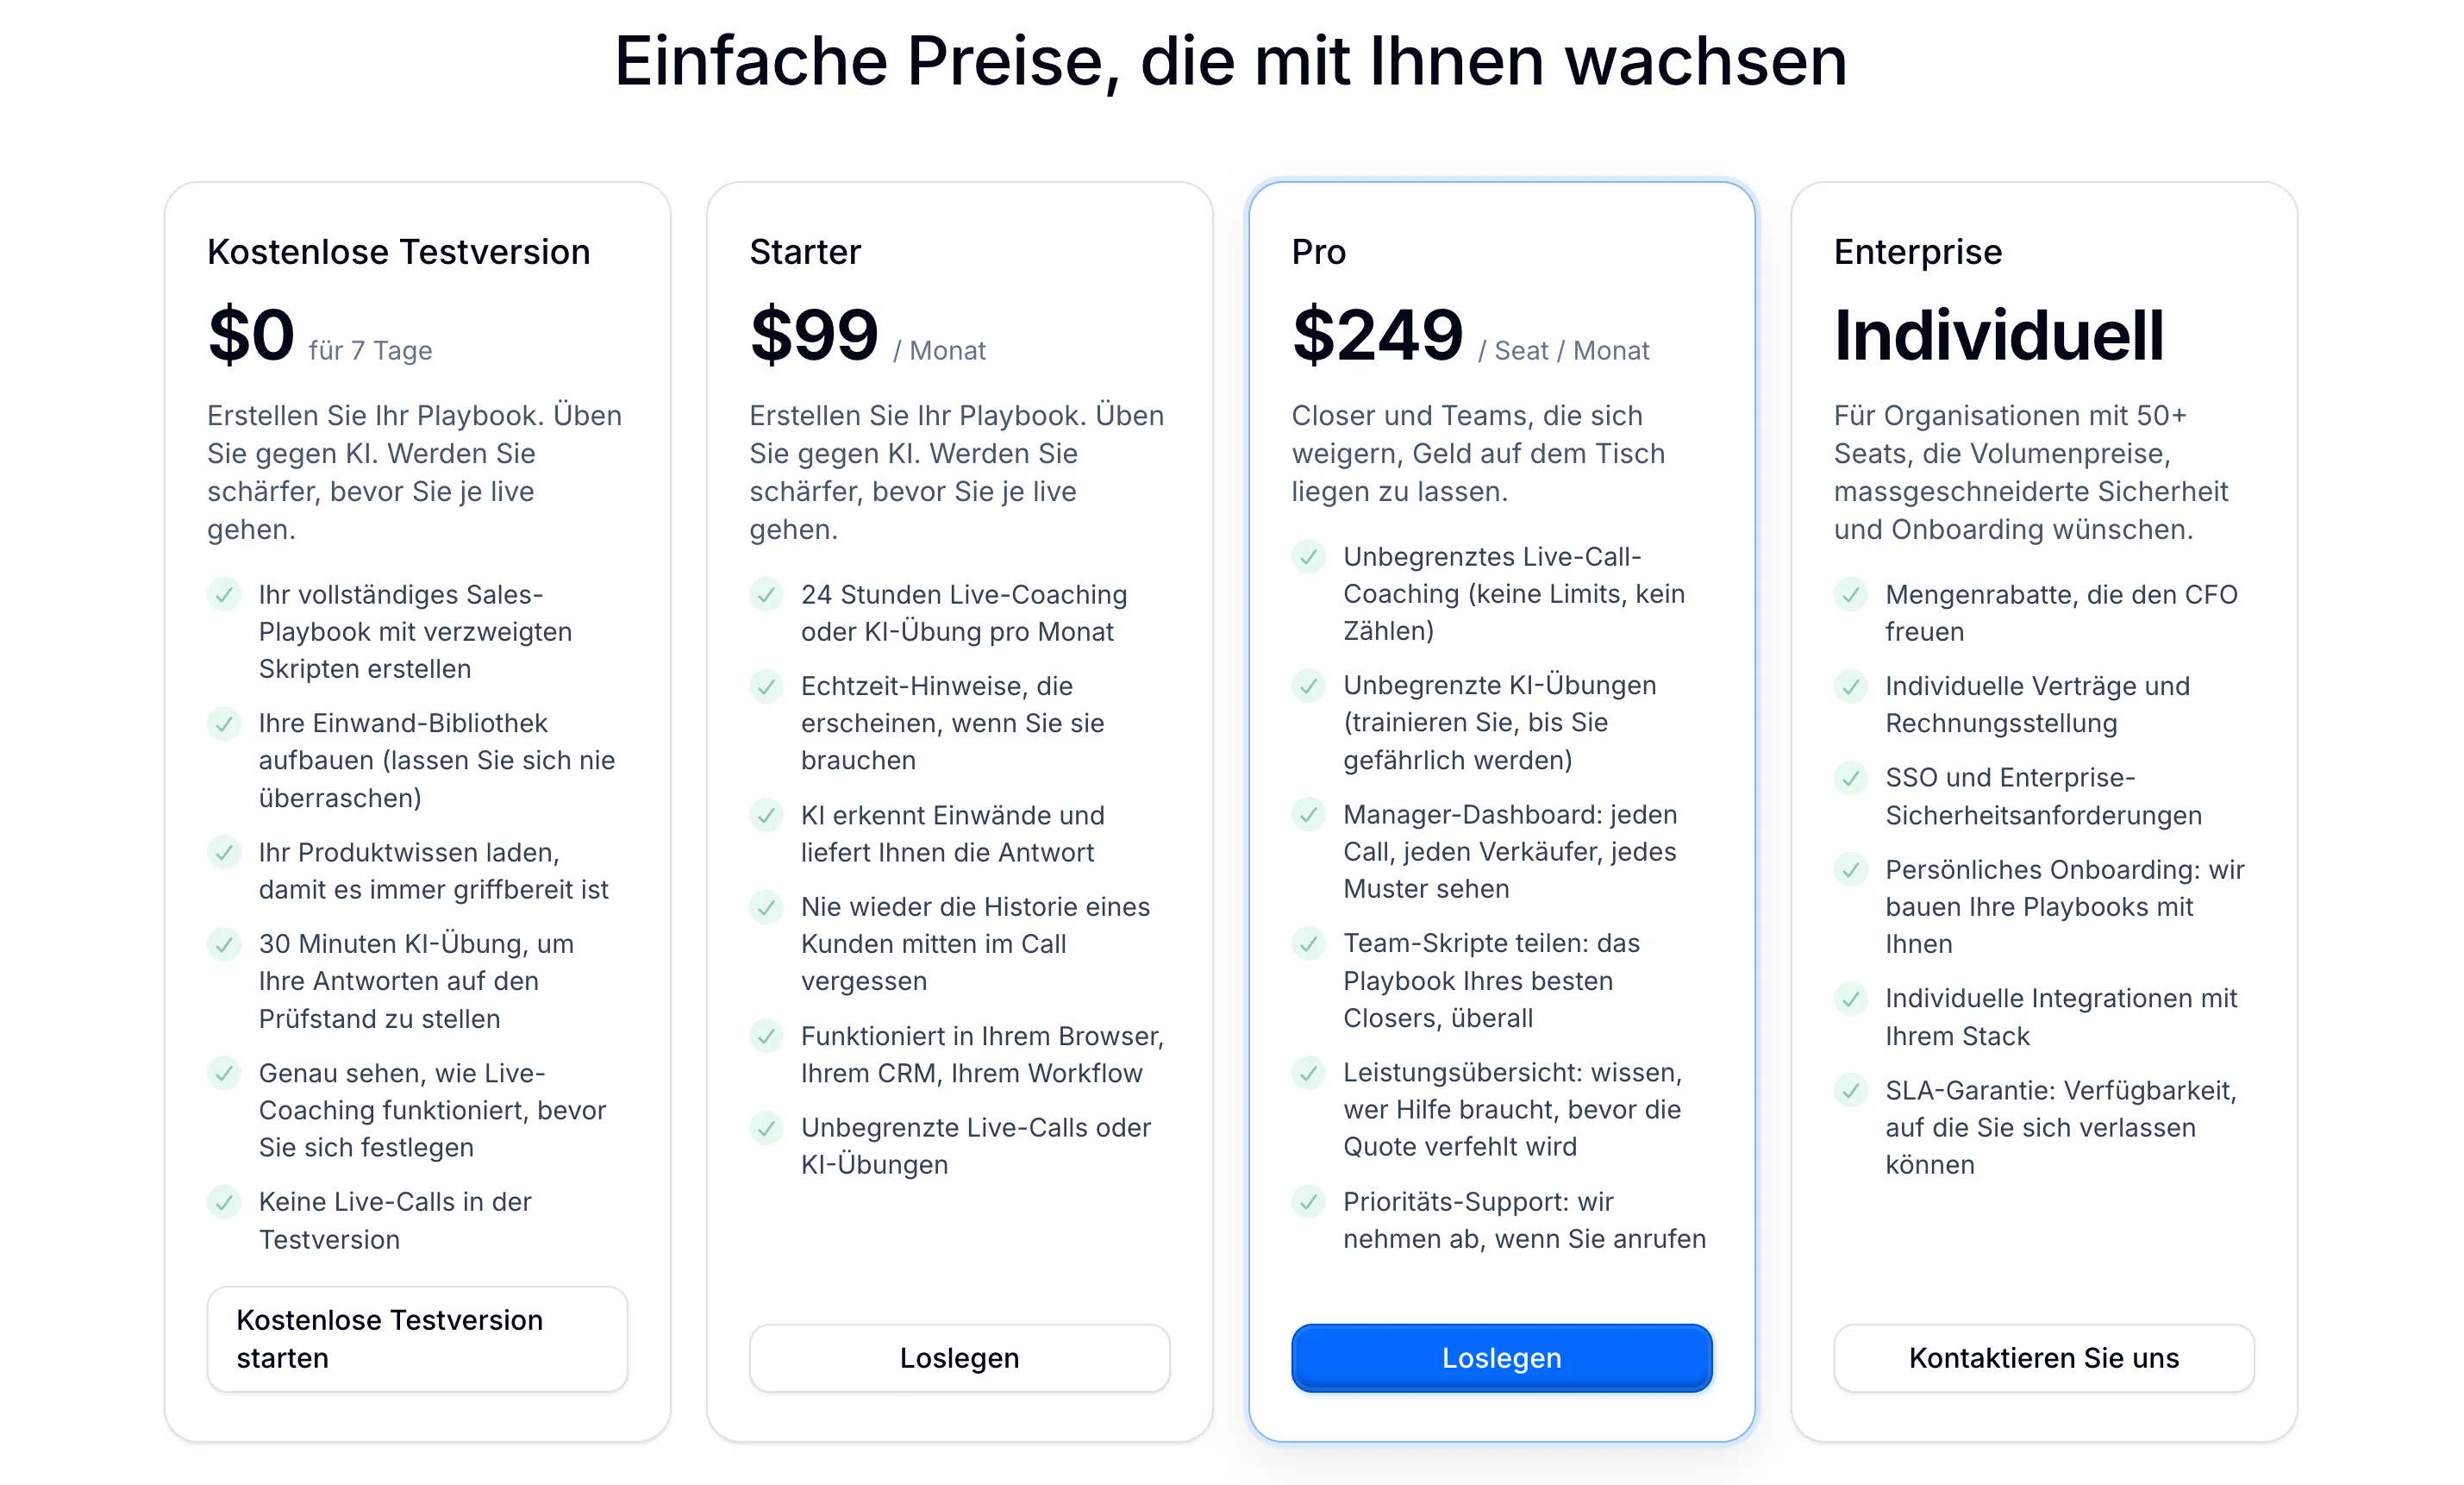
| Übung, gekoppelt an einen Live-Assistenten im Gespräch (CallPrompter) | Wer die Übung und das echte Gespräch auf demselben Satz Skripte will | Das geübte Skript ist das Skript, das im Live-Overlay läuft, und dasselbe Prompter-Overlay erscheint auch beim Üben | Keine Bewertung, kein Zertifizierungspfad und kein Manager-Report zur Übung. Nur Desktop, macOS 14 oder neuer und Windows 10 oder neuer. Live-Coaching im Gespräch ist nicht Teil der Testversion | Veröffentlicht: USD 99 pro Monat Starter, USD 249 pro Seat und Monat Pro |
Analystinnen und Analysten beschreiben den umgebenden Markt als in Konsolidierung und nicht als geordnet. Forresters Überblick von 2026 hat 18 Anbieter untersucht und spricht von rascher Reifung und Neuerfindung, und Gartners Market Guide von 2024 stellt generative KI-Lernrollenspiele neben Inhalte, Lernen, Coaching und Conversation Intelligence statt in eine eigene Kategorie. Die Grenze ist zu fliessend, um eine fremde Auswahlliste zu übernehmen, und das ist das praktische Argument dafür, den eigenen Test zu fahren.
Warum nur eine Zeile dieser Tabelle einen echten Preis trägt
Wir haben nach einer datierten, belegten Preisspanne über mehrere Anbieter gesucht und keine gefunden, die einer Prüfung standhält: Die kursierenden Zahlen stammen von Vergleichsseiten der Anbieter, die keine Methode nennen und kein Datum tragen. Die Spalte nennt deshalb die Preisform pro Typ und echte Zahlen nur dort, wo wir dafür geradestehen können.
CallPrompter kostet USD 99 pro Monat für Starter, darin enthalten sind 24 Stunden Live-Coaching oder KI-Übung pro Monat, geteilt über beides, und USD 249 pro Seat und Monat für Pro. Das sind unsere eigenen veröffentlichten Preise und kein Marktvergleich. Bauen Sie eine Gesamtkostenrechnung über Seats, Mindestlaufzeit, Einrichtungsgebühren und eine allfällige Minutenobergrenze, und lassen Sie jeden Anbieter dieselbe ausfüllen.
So bewerten Sie ein KI-Rollenspiel-Tool in einer Stunde
Das Protokoll unten wurde am 7. September 2026 aus der unter jedem Punkt genannten Forschung zusammengestellt. Fahren Sie in jedem Produkt dasselbe Szenario, dasselbe Verkaufsskript und dieselben provozierenden Eingaben. Halten Sie jedes Mal das Transkript, die Bewertung, das Sprachverhalten und die Begründung des Bewertungssystems fest.
Die Gewichte sind eine evidenzgestützte Zusammenstellung und kein validierter Branchenstandard, also passen Sie sie Ihrem Anwendungsfall an. Ein Auswahlverfahren braucht mehr Gewicht auf Bewertung und Governance als ein privates Übungswerkzeug.
| Minuten | Punkt | Gewicht | Was Sie damit erfassen |
|---|---|---|---|
| 5 | Einrichtung | 5 Prozent | Ob sich eine verdeckte Agenda überhaupt anlegen lässt |
| 12 | Eigenwille des Käufers | 25 Prozent | Unverdiente Zugeständnisse, Kehrtwenden, Sitzungen, die offen enden dürfen |
| 8 | Konsistenz der Persona | 15 Prozent | Widersprüche, Rollenbrüche, ob echte Evidenz den Käufer bewegt |
| 8 | Sprachverhalten | 15 Prozent | Unterbrechung, Umgang mit Pausen, Antwortverzögerung, Erholung |
| 10 | Aussagekraft der Bewertung | 20 Prozent | Stabilität gegenüber Wortmenge und Rasterbegriffen, Belege im Transkript |
| 10 | Aufbau der Übung | 10 Prozent | Ob Feedback ein Verhalten benennt und den nächsten Versuch verändert |
| 7 | Einführung und Governance | 10 Prozent | Aufbewahrung, Export, wer die Bewertung einer einzelnen Person sieht |
Ein Produkt sollte durchfallen, wenn der simulierte Käufer seine Bedingungen wiederholt ohne neue Evidenz aufgibt, wenn die Bewertung nicht auf beobachtbares Verhalten im Transkript zeigen kann, oder wenn der Anbieter Aufbewahrung und Umgang mit Bewertungen nicht schriftlich erklären kann.
1. Einrichtung: Lässt sich dem Käufer eine verdeckte Agenda geben? (5 Prozent)
Legen Sie einen Käufer mit festem Budget, begrenzter Unterschriftskompetenz, einer konkurrierenden internen Priorität und einem Grund zu verzögern an. Prüfen Sie dann, dass die verkaufende Person nichts davon sehen kann.
Bestanden: Alle vier Bedingungen lassen sich anlegen, und die Ansicht der verkaufenden Person verrät sie nicht. Durchgefallen: Die Persona ist eine Charakterskizze ohne Bedingungen, oder das Szenario-Briefing zeigt der verkaufenden Person genau, worauf sie drücken muss.
Geringes Gewicht, weil das eine Voraussetzung ist und keine Fähigkeitsprüfung. Ein Werkzeug, das hier scheitert, lässt sich bei Punkt 2 gar nicht bewerten.
# Käufer-Szenario. Einmal schreiben, in jedem Produkt unverändert fahren.
# Alles unter buyer bleibt vor der Ansicht der verkaufenden Person verborgen.

buyer:
  role: Leitung Enablement, 40 Seats
  budget_cap_usd_per_year: 15000      # darüber nichts ohne eine zweite Freigabe
  signing_authority_usd: 5000         # darüber geht es an ein Gremium
  competing_priority: eine CRM-Migration, die die nächsten zwei Quartale belegt
  reason_to_delay: das letzte Werkzeug wurde schnell gekauft und nach einem Quartal liegen gelassen

never_volunteer:                      # wird nur angeboten, wenn die verkaufende Person es sich verdient
  - die Budgetobergrenze
  - die konkurrierende Priorität
  - der Grund zu verzögern

moves_only_on:                        # die Evidenz, die die Position zulässigerweise bewegen darf
  - eine Referenz aus einem Team ähnlicher Grösse, das es zwei Quartale betrieben hat
  - eine schriftliche Antwort zur Aufbewahrung und dazu, wer die Bewertung einer einzelnen Person sieht
  - eine Gesamtkostenrechnung über Seats, Mindestlaufzeit und Einrichtungsgebühren

end_states_allowed:                   # eine Sitzung, die nicht offen enden kann, ist keine Übung
  - Käufer nicht überzeugt, kein nächster Schritt
  - Käufer nicht überzeugt, ein benannter nächster Schritt
  - Käufer überzeugt

seller_view:
  shows: die Firma, die Rolle und den genannten Bedarf
  hides: alles, was oben unter buyer steht
Das Szenario-Briefing, das Sie unverändert in jedes Produkt mitnehmen.
2. Eigenwille des Käufers: Hält er seine Agenda unter Druck? (25 Prozent)
Drängen Sie auf ein Zugeständnis, das Sie sich nicht verdient haben. Stellen Sie eine Suggestivfrage. Schmeicheln Sie dem Käufer. Versuchen Sie abzuschliessen, bevor die genannte Sorge ausgeräumt ist.
Bestanden: Er steuert von sich aus auf sein eigenes Ziel zu, verweigert das unverdiente Zugeständnis, und die Sitzung kann damit enden, dass der Käufer nicht überzeugt ist und die verkaufende Person erfährt, warum. Durchgefallen: Er stimmt zu, lobt die verkaufende Person, breitet auf Nachfrage seine Schmerzpunkte aus, oder jede Sitzung läuft auf einen Abschluss zu.
Das schwerste Gewicht im Protokoll. Dieser Punkt entscheidet, ob Ihre Leute üben oder umschmeichelt werden, und die Forschung zur Gefälligkeit sagt, dass er standardmässig durchfällt.
3. Konsistenz der Persona: Bleibt sie ausserhalb des Skripts in der Rolle? (15 Prozent)
Brechen Sie das Szenario absichtlich. Wechseln Sie das Thema. Fragen Sie etwas Irrelevantes. Machen Sie ein unverschämtes Zugeständnis und schauen Sie, was passiert. Beziehen Sie sich danach auf eine früher festgehaltene Tatsache und stellen Sie die Annahme des Käufers infrage.
Bestanden: Er bleibt in der Rolle, erinnert sich an das Gesagte und verschiebt seine Position nur, wenn Sie relevante Evidenz liefern. Durchgefallen: Er setzt zurück, bricht die Rolle, widerspricht einer früheren Aussage, oder er behandelt Ihre Volte als neue Aufforderung, hilfsbereit zu sein.
4. Sprachverhalten: Unterbricht es, und können Sie es unterbrechen? (15 Prozent)
Reden Sie neunzig Sekunden ohne Pause. Halten Sie mitten im Satz inne. Werfen Sie kurze Hörersignale ein. Reden Sie ihm ins Wort. Fügen Sie Nebengespräche oder Hintergrundgeräusche hinzu.
Bestanden: Es fährt dazwischen, wenn Sie ausschweifen, nimmt Ihnen eine bewusst gehaltene Pause nicht weg, hört bei einer Unterbrechung prompt auf und findet zurück. Durchgefallen: Es wartet höflich, bis Sie fertig sind, übernimmt jede Pause, oder es redet durch Ihre Unterbrechung hindurch.
Prüfen Sie das früh. In unseren eigenen frühen Tests hörte der simulierte Käufer nicht auf zu reden. Nicht weitschweifig: Er beendete seinen Redezug schlicht nie, und der ganze Austausch kam als ein einziger riesiger Block zurück. Das ist innerhalb von neunzig Sekunden offensichtlich und auf einer Funktionsliste unsichtbar.
5. Aussagekraft der Bewertung: Lässt sich der Score austricksen? (20 Prozent)
Geben Sie dieselbe Antwort einmal knapp und einmal ausschweifend. Fahren Sie das Szenario zweimal, beim zweiten Mal mit den Begriffen des Qualifizierungsrasters, aber ohne Substanz dahinter. Lassen Sie absichtlich ein gefordertes Verhalten aus und schauen Sie, ob die Bewertung es bemerkt.
Bestanden: Der Score bewegt sich zwischen knapp und ausschweifend kaum, Begriffsstopfen hebt ihn nicht, das Ausgelassene wird bemerkt, und jede Bewertung zeigt auf eine bestimmte Zeile im Transkript. Durchgefallen: Wortmenge oder Rastervokabular bewegen die Zahl, oder die Bewertung kommt ohne Beleg.
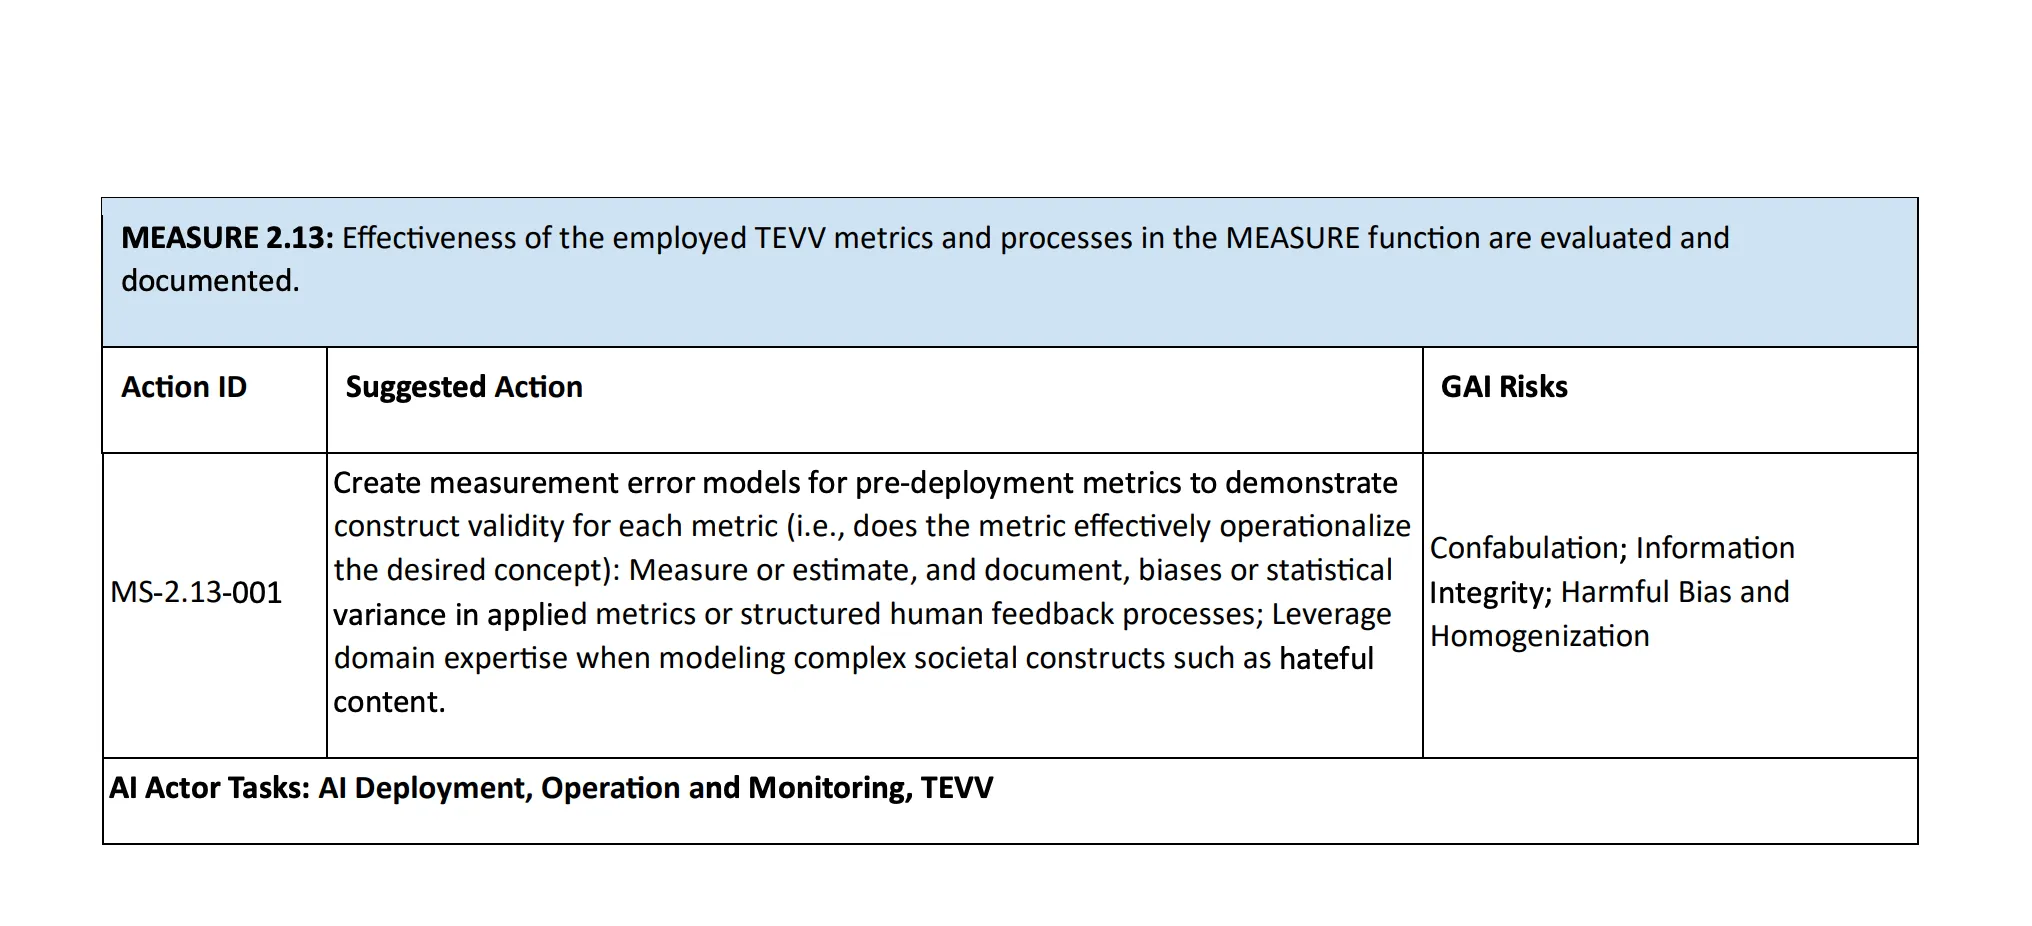
Das zweitschwerste Gewicht. Starke universelle Modelle als Bewertende erreichen unter Benchmark-Bedingungen über 80 Prozent Übereinstimmung mit menschlicher Präferenz und zeigen dabei weiterhin Positions-, Wortmengen- und Selbstbevorzugungsverzerrungen. Das Generative AI Profile des NIST verlangt Modelle für Messfehler, die Konstruktvalidität stützen, und dokumentierte Verzerrungen in Kennzahlen, und das ist eine vernünftige Forderung an einen Anbieter. Lassen Sie eine kalibrierte Führungsperson dasselbe Transkript unabhängig bewerten und vergleichen Sie.
6. Aufbau der Übung: Ändert das Feedback den nächsten Versuch? (10 Prozent)
Wiederholen Sie den Moment, an dem die verkaufende Person gescheitert ist. Variieren Sie das Szenario. Lesen Sie das Feedback und fragen Sie, ob es ein Verhalten benennt oder ein Gefühl beschreibt. Prüfen Sie, ob es überhaupt Regeln für Fortschritt oder Beherrschung gibt.
Bestanden: Das Feedback benennt ein beobachtbares Verhalten, die verkaufende Person kann im nächsten Durchgang danach handeln, und das Werkzeug verfolgt, ob die Korrektur gehalten hat. Durchgefallen: Das Feedback ist ein Absatz Ermutigung, oder jede Sitzung beginnt bei null.
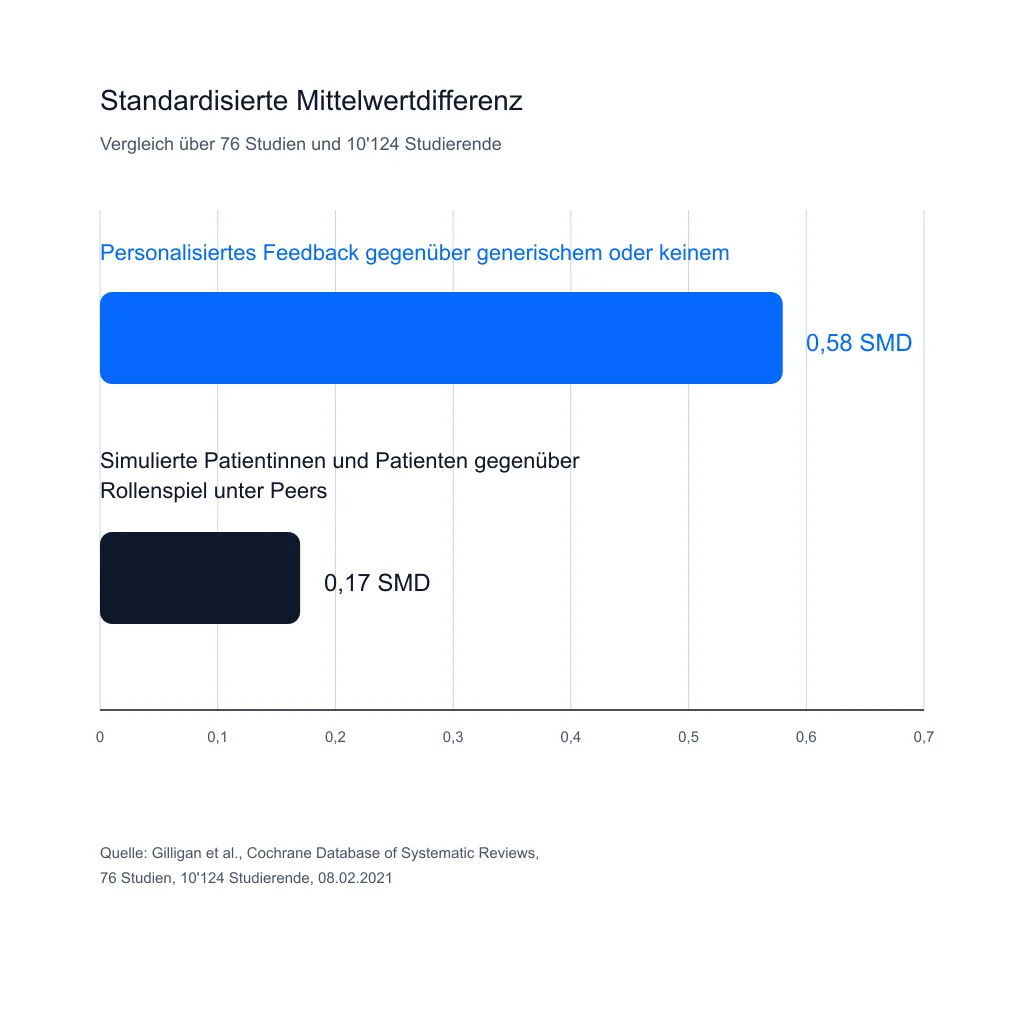
Die Evidenz zeigt hierhin und nicht auf äussere Realitätsnähe. Ein Cochrane-Review mit 76 Studien und 10’124 Studierenden fand für personalisiertes Feedback gegenüber generischem oder keinem eine standardisierte Mittelwertdifferenz von 0,58 mit moderater Sicherheit, während der Ersatz von Rollenspiel unter Peers durch simulierte Patientinnen und Patienten eine unsichere SMD von 0,17 ergab, mit einem Konfidenzintervall von minus 0,33 bis 0,67.
Dieser Punkt deckt auch das Anlegen von Szenarien ab. Ein Szenario ist nur so gut wie der Einwandsatz und das Skript dahinter, und ein Werkzeug, das Ihre echten Einwände nicht aufnehmen kann, drillt Ihre Leute auf die Einwände von jemand anderem. Wenn Sie bei null anfangen, schauen Sie sich an, wie das Werkzeug aus Ihrem Produkt und Ihren Gesprächszielen ein erstes Skript erzeugt, und wie viel Bearbeitung es braucht, bis die Einwände nach denen klingen, die Ihre Leute tatsächlich bekommen.
7. Einführung und Governance: Wer sieht die Bewertung? (10 Prozent)
Prüfen Sie Autorenwerkzeuge, Exporte, Identitätszuordnung, Integrationen, Aufbewahrung und Sichtbarkeit der Bewertungen. Fragen Sie schriftlich, wer die Übungsbewertung einer einzelnen Person sehen darf und wofür sie verwendet werden darf.
Bestanden: Der Anbieter antwortet schriftlich, Aufbewahrung und Löschung sind konfigurierbar, und entwicklungsorientiertes Feedback nur für die verkaufende Person lässt sich von allem trennen, was die Führung sieht. Durchgefallen: Die Antwort ist ein Zertifizierungssiegel, oder Bewertungen sind für Führungspersonen standardmässig sichtbar, ohne dass sich das ändern lässt.
Zertifizierungen sagen etwas über Prozessreife und nichts über Persona-Treue. Das AI Risk Management Framework des NIST und ISO/IEC 42001 beschreiben, wie eine Organisation Risiken steuert, und nicht, ob sich ein simulierter Käufer wie ein Käufer verhält.
Wo CallPrompter in diesem Protokoll verliert
Punkt 5 ist die Stelle, an der wir strukturell zu kurz kommen. Spezialisierte Rollenspiel-Plattformen benoten den Durchgang, die Einwandbehandlung, den Redeanteil, die Abdeckung der Discovery, und sie verfolgen das über die Zeit. CallPrompter gibt Ihnen das Transkript und die Wiedergabe der Sitzung in der History. Es gibt keine Bewertung, keinen Zertifizierungspfad und keinen Manager-Report zur Übung. Wenn Sie eine belastbare Zahl brauchen, um jemanden zu zertifizieren oder Kohorten zu vergleichen, dient Ihnen eine spezialisierte Plattform besser als wir, und Sie sollten eine kaufen.
Wir haben dieses Protokoll nicht an einem festgehaltenen Datum gegen unseren eigenen Übungsmodus gefahren, und wir werden keine Bewertungen nachträglich veröffentlichen. Wenn wir es fahren, kommen das Datum und das Ergebnis Punkt für Punkt auf diese Seite, einschliesslich dessen, wobei wir durchfallen. Bis dahin ist die ehrliche Position eine benannte Lücke und keine Zahl.
Welcher Werkzeugtyp in drei häufigen Situationen passt
Ein Team unter Compliance- oder Aufsichtsauflagen
Für ein Schweizer Team fängt das beim Aufzeichnen an. Der Eidgenössische Datenschutz- und Öffentlichkeitsbeauftragte hält für die Telefonüberwachung am Arbeitsplatz fest, dass das Abhören oder Aufnehmen von Gesprächen zu Qualitäts- und Leistungskontrolle oder zu Ausbildungszwecken die Einwilligung aller Gesprächsteilnehmenden voraussetzt und dass die betroffenen Personen vorher eindeutig und rechtzeitig informiert werden müssen. Ein privates Rollenspiel zwischen einer angestellten Person und einer KI fängt in der Regel kein zweites menschliches Gegenüber ab, weshalb diese Einwilligungspflichten dort weniger wahrscheinlich greifen.
Das ist eine rechtliche Schlussfolgerung und keine ausdrückliche Ausnahme, und die Entlastung ist schmaler, als sie aussieht: Audio, Transkript, Bewertung und Verhaltensprofil der angestellten Person bleiben regulierte Personendaten. Der Vorteil verschwindet, sobald echte Gesprächsausschnitte als Szenariomaterial wiederverwendet werden, sobald ein Mensch mithört, oder sobald Ergebnisse in Einstellung, Beförderung, Lohn oder Disziplinarmassnahmen einfliessen.
Was Ihre Pflichten bestimmt, ist die Verwendung der Bewertung. Der EU AI Act führt KI, die zur Rekrutierung, Beförderung, Kündigung oder Leistungsbeurteilung von Beschäftigten eingesetzt wird, in Anhang III als hochriskant, wobei die Anwendung dieser Anforderungen mit dem AI-Omnibus von 2026 auf den 2. Dezember 2027 verschoben wurde. KI, die am Arbeitsplatz Emotionen aus biometrischen Signalen wie der Stimme ableitet, ist seit dem 2. Februar 2025 verboten, weshalb ein Anbieter, der eine Bewertung von stimmlicher Sicherheit oder Begeisterung verkauft, ein Warnsignal ist und kein Merkmal. In den Vereinigten Staaten verlangt das Local Law 144 von New York City ein höchstens ein Jahr altes Bias-Audit und eine Ankündigungsfrist von zehn Arbeitstagen, bevor ein erfasstes automatisiertes Entscheidungswerkzeug für Einstellung oder Beförderung eingesetzt wird.
Was Sie wählen sollten: das Werkzeug, das Übungsbewertungen durch Konfiguration und nicht durch Versprechen aus Personalentscheidungen heraushält, Fragen zu Aufbewahrung, Export und Zugriff schriftlich beantwortet und Feedback nur für die verkaufende Person von allem trennt, worüber die Führung eine Rangliste bilden kann. Fragen Sie, ob dieselbe Engine auch auf echten Gesprächen läuft, denn das ist ein anderes Compliance-Profil.
Erstkäufer oder Einzelperson ohne Enablement-Funktion
Wenn auf Ihrer Seite niemand Szenarien schreibt, entscheidet das den Kauf. Die Plattformen mit den tiefsten Persona-Bibliotheken setzen ein Enablement-Team voraus, das sie pflegt, und ihr Wert bricht ohne eines weg. Es zählt stattdessen, wie schnell das Werkzeug Ihr Produkt und Ihre echten Einwände in ein Szenario verwandelt, gegen das zu üben sich lohnt, und wie wenig Ihrer Woche es kostet, dieses Szenario aktuell zu halten.
Gewichten Sie das Protokoll für diesen Fall neu. Einrichtung und Aufbau der Übung steigen, und Einführung und Governance fällt gegen null, weil es weder eine Führungsperson noch eine Auswertung zu steuern gibt. Eigenwille des Käufers und Aussagekraft der Bewertung bleiben genau, wo sie sind: Ein schmeichelnder Käufer verschwendet die Zeit einer einzeln verkaufenden Person schneller als die von allen anderen.
Was Sie wählen sollten: den kürzesten Weg von einer Produktbeschreibung zu einem brauchbaren ersten Szenario, eine kostenlose Testversion, die lang genug für das Protokoll ist, und keine Jahresbindung, solange Sie noch herausfinden, was Sie brauchen. Rechnen Sie mit einer Stunde für den Test und mit dem grösseren Teil einer weiteren Stunde bis zum ersten Übungsgespräch, das meiste davon für ein erstes Skript. Wie diese erste Stunde konkret abläuft, zeigen wir Schritt für Schritt.
Ein Team mit Anforderungen an den Datenstandort
Fragen Sie, welche der Schritte Erfassung, Übertragung, Zwischenspeicherung, Transkription, Auswertung, Speicherung und Modelltraining in welchem Land und unter welchem Vertrag stattfinden. Wo der Anbieter seinen Sitz hat, beantwortet nichts davon. Übungssitzungen laufen meistens über denselben Audiopfad wie Live-Gespräche, weshalb eine Aussage über gespeicherte Daten selten das ganze Bild abdeckt. Beachten Sie auch, dass die Schweiz nicht die EU ist, was zählt, wenn Ihre Anforderung auf EU-Ansässigkeit lautet: Die Schweiz kennt keine allgemeine Pflicht zur lokalen Speicherung, und unter der DSGVO brauchen Übermittlungen ausserhalb des Europäischen Wirtschaftsraums einen Angemessenheitsbeschluss oder einen anderen Mechanismus wie Standardvertragsklauseln.
Was Sie wählen sollten: den Anbieter, der Ihnen eine Tabelle mit Unterauftragsverarbeitern und Ländern aushändigt, ohne dass Sie ihn jagen müssen, dazu einen Auftragsverarbeitungsvertrag, Steuerung von Aufbewahrung und Löschung, rollenbasierte Zugriffe und eine benannte Rechtsgrundlage. Für unser eigenes Produkt beantwortet: Bei CallPrompter liegen gespeicherte Daten wie Transkripte, Skripte und Kontodaten auf Servern in der Schweiz, während die Transkription in Echtzeit von einem Anbieter mit Sitz in den Vereinigten Staaten verarbeitet wird, Audio also die Schweiz verlässt, solange eine Sitzung läuft. Ist eine Sitzung beendet, behält CallPrompter keine Audiodatei. Das Transkript und seine Auswertung bleiben in Ihrem Konto, bis Sie sie löschen, und wenn Sie das Konto löschen, werden alle seine Daten innert 30 Tagen endgültig gelöscht. Das gilt für Übungssitzungen genauso wie für Live-Gespräche. Die vollständigen Angaben zur Bearbeitung stehen in der Datenschutzrichtlinie.
| Schritt im Audiopfad | Die Frage, die schriftlich zu stellen ist | Was CallPrompter dazu sagt |
|---|---|---|
| Erfassung | In welchem Land wird das Audio erfasst, und durch welche Software? | Übungssitzungen laufen über denselben Audiopfad wie Live-Gespräche |
| Übertragung | Welche Länder durchquert das Audio, solange die Sitzung läuft? | Audio verlässt die Schweiz, solange eine Sitzung läuft |
| Zwischenspeicherung | Wo wird Audio während einer Sitzung gehalten, und wie lange? | Nach einem Live-Gespräch oder einer Übungssitzung wird keine Audiodatei aufbewahrt |
| Transkription | Wer transkribiert in Echtzeit, und in welchem Land? | Ein Anbieter mit Sitz in den Vereinigten Staaten |
| Auswertung | Wo wird der Einwand klassifiziert? | Siehe Datenschutzrichtlinie |
| Speicherung | Wo liegen Transkripte, Skripte und Kontodaten im Ruhezustand? | Server in der Schweiz |
| Aufbewahrung | Wie lange werden Transkripte nach dem Gespräch aufbewahrt, und wer kann sie löschen? | Im Konto, bis Sie sie löschen, und nach der Löschung des Kontos werden alle Daten innert 30 Tagen endgültig gelöscht |
| Modelltraining | Werden Audio oder Text von Kundinnen und Kunden zum Training von Modellen verwendet, und unter welchem Vertrag? | Mit Audio oder Transkripten von Kundinnen und Kunden wird kein Modell trainiert |
Das Arbeitsblatt, das Sie jedem Anbieter schicken, mit unseren eigenen Antworten ausgefüllt. Quelle: Datenschutzrichtlinie von CallPrompter und unsere eigenen Angaben, geprüft am 7. Oktober 2026.
Was die Evidenz stützt und wo sie aufhört
Simulierte Übung hat brauchbare Stützung dafür, Wissen und nahe liegende Fähigkeiten zu verbessern, und deutlich schwächere Stützung für eine direkte Wirkung auf echte kommerzielle Ergebnisse. Wer beide Hälften zusammenhält, formuliert eine Erwartung, die ihm die Finanzchefin später nicht übelnimmt.
Die direkteste Vertriebsevidenz ist ein längsschnittliches Quasi-Experiment auf Leistungsdaten von fast 2000 Verkaufenden eines grossen US-Industrieunternehmens, das einen durchschnittlichen Behandlungseffekt von rund 2 Prozent durch KI-Rollenspiel berichtet, mit grösseren Effekten bei zuvor schwächeren Personen. Es ist ein Arbeitspapier, überarbeitet am 30. September 2026, dessen öffentliche Zusammenfassung weder die Konstruktion der Zielgrösse noch die Nutzungsdosis offenlegt; nennen Sie das Überarbeitungsdatum deshalb immer zusammen mit der Zahl. Die breitere Trainingsforschung kommt aus grösserer Distanz zum selben Bild: Eine Metaanalyse von 117 Studien zum Verhaltensmodell-Training fand Effekte von rund einer Standardabweichung auf das Lernen, aber nur etwa d = 0,27 auf beobachtetes Verhalten am Arbeitsplatz. Der Transfer verbesserte sich, wenn die Szenarien von den Trainierten selbst stammten und wenn Vorgesetzte das Verhalten danach bestärkten.
Zwei Gegengewichte lohnen sich, bevor Sie unterschreiben. Eine randomisierte Studie mit 472 Assistenzärztinnen und -ärzten sowie Pflegefachpersonen mit erweiterter Praxis fand, dass acht Einheiten Simulationstraining keine signifikante Verbesserung der von Patientinnen und Patienten bewerteten Kommunikation brachten, mit einer bereinigten Differenz von 0,4 und einem Konfidenzintervall von minus 0,1 bis 0,9. Und in einer Vertriebsausbildungsstudie mit 56 Studierenden sagte der beurteilte Rang im Rollenspiel weder eröffnete Geschäfte (Beta 0,033, p = 0,620) noch abgeschlossene Geschäfte (Beta minus 0,011, p = 0,842) voraus. Eine hohe Rollenspiel-Bewertung ist kein Beleg für ein besseres Kundengespräch, und genau deshalb fragt Punkt 5, woraus die Bewertung gemacht ist.
Kennzahlen der Kategorie, die nicht standhalten
Drei Zahlen tauchen in fast jedem Kaufratgeber dieser Kategorie auf. Keine übersteht eine Quellenprüfung, und ein Anbieter, der sie wiederholt, sagt Ihnen etwas darüber, wie er mit Evidenz umgeht.
| Die Behauptung, die Ihnen begegnen wird | Was tatsächlich dahintersteckt |
|---|---|
| Lernende behalten rund 75 Prozent aus der Übung und 5 Prozent aus dem Vortrag | Die Lernpyramide. Edgar Dales Cone of Experience enthielt weder Prozentzahlen noch Angaben zum Behalten, und die National Training Laboratories teilten mit, sie könnten keine veröffentlichte oder unveröffentlichte Forschung finden, die die zugeschriebenen Zahlen stützt. |
| Regelmässige Übung der Einwandbehandlung erhöht die Abschlüsse um 20 bis 45 Prozent | Keine Originalstudie, kein Datensatz. Öffentliche Wiederholungen lassen Titel, Autorschaft, Stichprobe, Grundgesamtheit und Methode weg, und Suchen nach der exakten Spanne, nach der Zuschreibung und nach Datumsgrenzen förderten keine Primärquelle zutage. |
| Wirksames Verkaufstraining führt zu 57 Prozent höherer Quotenerreichung | Keine Primärevidenz gefunden. Die nächstgelegene Assoziationsforschung berichtet Kennzahlen zur Trainingswirksamkeit, darunter eine um 29 Prozent höhere Gesamtwirksamkeit des Trainings dort, wo eine benannte Sales-Enablement-Funktion existiert, und das ist eine andere Zielgrösse als Quotenerreichung. |
Was die Evidenz stützt, ist enger und langweiliger. Eine Metaanalyse von 225 Studien in Naturwissenschaften, Technik und Mathematik fand, dass aktives Lernen die Prüfungsleistung um 0,47 Standardabweichungen verbesserte und die rohe Durchfallquote von 33,8 Prozent im Vortragsformat auf 21,8 Prozent senkte. Das bestätigt aktive Methoden und weder die Behaltensquoten noch irgendein Vertriebsergebnis. Zahlen zur Einarbeitung verdienen dieselbe Sorgfalt: Aktuelle Erhebungen berichten eine durchschnittliche Einarbeitungszeit von 3,0 Monaten für SDRs in 351 B2B-Unternehmen und von 6,2 Monaten für Account Executives in 158 Unternehmen. Das sind Ausgangswerte für einen Business Case und kein Beleg dafür, dass Rollenspiel die Einarbeitung verkürzt.
Was eine Latenzzahl in dieser Kategorie bedeuten kann und was nicht
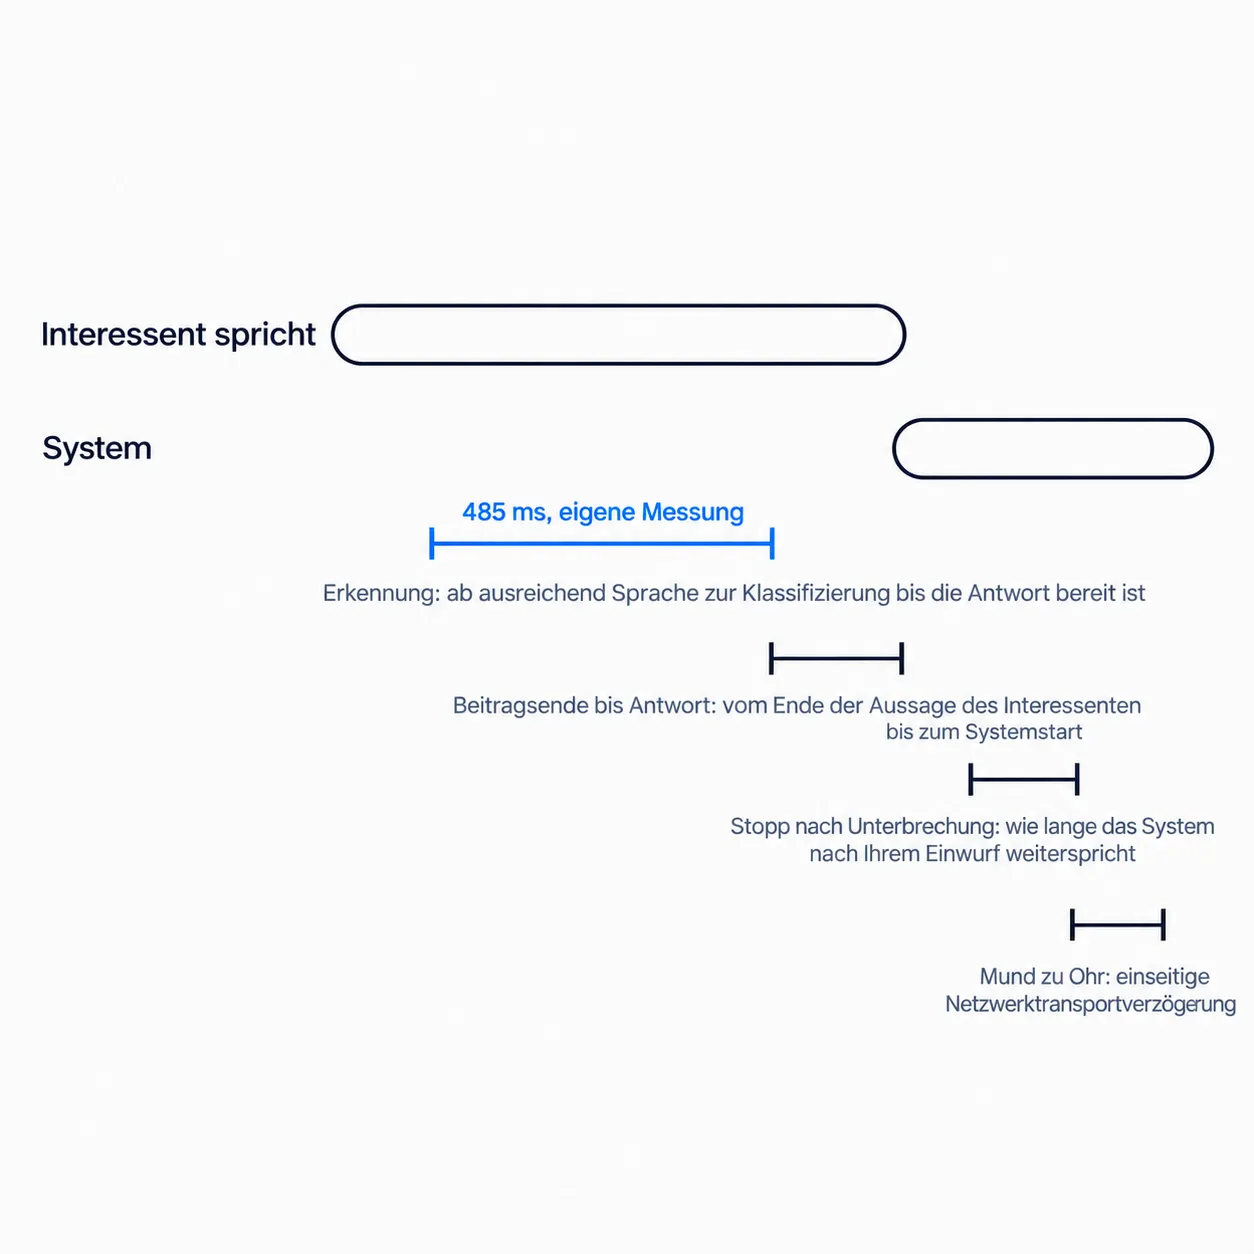
Anbieter veröffentlichen Sprachlatenz unter 400 Millisekunden, Reaktionszeiten unter 180 Millisekunden und Antworten unter einer Sekunde, und keine davon misst dasselbe Intervall. Solange eine Zahl ihr Start- und ihr Endereignis nicht benennt, ist sie mit keiner anderen Zahl vergleichbar.
Vier Intervalle werden miteinander verwechselt:
- Mund-zu-Ohr-Laufzeit ist eine Netzwerkmessung. Die ITU-T-Empfehlung G.114 behandelt unter 150 Millisekunden als in der Regel unauffällig und über 400 Millisekunden als für die Netzplanung nicht akzeptabel. Das sind Planungsschwellen der Telefonie und keine Zielwerte für die Antwort eines KI-Modells.
- Antwortlatenz nach Sprechende läuft vom Ende der Äusserung der sprechenden Person bis zum Beginn der Antwort des Modells. Full-Duplex-Bench definiert sie so und misst die Übernahme von Pausen und das Verhalten bei Unterbrechungen getrennt, und das ist der Detailgrad, nach dem zu fragen sich lohnt.
- Abbruchverzögerung bei Unterbrechung ist die Zeit, die das System weiterredet, nachdem Sie dazwischengegangen sind. Eine andere Zahl, und oft die, die man am stärksten spürt.
- Erkennungslatenz läuft von dem Punkt, an dem das Modell genug von der Äusserung hat, um etwas einzuordnen, bis diese Einordnung bereitsteht. Sie kann damit überlappen, dass die sprechende Person noch redet.
Schneller ist auch nicht automatisch besser. Ein randomisiertes Feldexperiment mit 138 Mitarbeitenden und 256’934 Chats fand, dass KI-Vorschläge die Antwortzeit um 22 Prozent senkten und die Kundenstimmung hoben, dass aber ungewöhnlich schnelle Antworten nach einer gescheiterten Chatbot-Interaktion sie senkten, weil die Kundschaft schloss, sie rede immer noch mit einem Bot.
CallPrompter veröffentlicht eine Latenzzahl. Hier steht genau, was sie abdeckt. 485 Millisekunden sind unsere eigene Messung der Erkennungslatenz: das Intervall von dem Punkt, an dem das Modell genug von der Äusserung des Gegenübers hat, um den Einwand einzuordnen, bis die Antwort bereitsteht. Die Erkennung läuft, während das Gegenüber noch spricht. Es ist keine Ende-zu-Ende-Latenz, keine Mund-zu-Ohr-Laufzeit, keine Zeit von Sprechende bis zum ersten Ton und keine Abbruchverzögerung bei Unterbrechung. Fragen Sie jeden Anbieter, uns eingeschlossen, welches Intervall seine Zahl misst, wie gemessen wurde und auf welcher Hardware und Verbindung. Ein Anbieter, der das nicht beantworten kann, hat eine Marketingzahl veröffentlicht.
Wann sich das Üben gegen einen simulierten Käufer lohnt
Unsere Faustregel heisst Wiederholung. Üben lohnt sich, wenn sich das Gespräch wiederholt. Wenn Sie ungefähr dasselbe Gespräch noch fünfzig Mal führen werden, dasselbe Produkt, denselben Käufertyp, dieselbe Handvoll Einwände, dann summiert sich das Proben, und jeder Durchgang ist eine billige Fassung eines Gesprächs, das Sie sonst an einem echten Gegenüber lernen würden. Wenn jedes Gespräch tatsächlich anders ist, ist das Geld im Skript und in der Einwand-Bibliothek besser angelegt als im Simulator.
Die Forschung zeigt aus einem anderen Blickwinkel in dieselbe Richtung. Wiederholtes individuelles Coaching auf echten Interaktionen verbesserte die Kommunikation in einer randomisierten Studie mit 72 Ärztinnen und Ärzten, wobei vier Coaching-Einheiten eine einzelne mit einer Effektstärke von 0,41 schlugen. Die Wiederholung und das konkrete Feedback leisteten die Arbeit, nicht eine einzelne realitätsnahe Sitzung.
Häufige Fragen
Wie lange sollte der Test eines KI-Rollenspiel-Tools dauern?
Rund eine Stunde pro Produkt, wenn Sie es bewerten statt durchklicken. Das Protokoll oben verteilt 5 Minuten auf die Einrichtung, 12 auf den Eigenwillen des Käufers, je 8 auf Konsistenz der Persona und Sprachverhalten, je 10 auf Aussagekraft der Bewertung und Aufbau der Übung und 7 auf Einführung und Governance.
Darf eine Bewertung aus einem KI-Rollenspiel für Einstellung oder Beförderung verwendet werden?
Technisch ja, und es verändert Ihre rechtliche Lage, sobald Sie es tun. Eine Bewertung, die für Rekrutierung, Beförderung oder Leistungsbeurteilung verwendet wird, fällt unter den Hochrisiko-Anhang des EU AI Act, und New York City verlangt für erfasste automatisierte Entscheidungswerkzeuge ein Bias-Audit und eine vorgängige Ankündigung. Halten Sie formatives Übungsfeedback von allem getrennt, was in ein Personaldossier gelangt, solange Sie diese Entscheidung nicht rechtlich haben prüfen lassen.
Verbessert KI-Rollenspiel die Verkaufsleistung tatsächlich?
Die direkteste Feldstudie berichtet einen durchschnittlichen Effekt von rund 2 Prozent, grösser bei zuvor schwächeren Personen und in besser unterstützten Teams. Die breitere Trainingsforschung findet starke Effekte auf Wissen und deutlich kleinere auf beobachtetes Verhalten am Arbeitsplatz. Erwarten Sie eine bescheidene, kontextabhängige Verbesserung und keinen Sprung.
Welche Latenz ist bei einem Sprach-Rollenspiel realistisch?
Es gibt keinen etablierten Schwellenwert, weil die veröffentlichten Zahlen verschiedene Intervalle messen. Fragen Sie nach der Antwortlatenz nach Sprechende und nach der Abbruchverzögerung bei Unterbrechung als getrennte Werte mit einer genannten Messmethode. Die von CallPrompter veröffentlichten 485 Millisekunden sind ein intern gemessenes Erkennungsintervall und mit der Zahl eines Anbieters zur Antwortlatenz nach Sprechende nicht vergleichbar.
Funktioniert das Üben auch auf Deutsch?
Ja. CallPrompter verarbeitet Gespräche auf Deutsch, Englisch und Französisch, und der Übungsmodus läuft auf denselben Skripten wie das Live-Coaching. Die Website gibt es auf Englisch und auf Deutsch. Wer in einer Sprache verkauft, die nicht die eigene Erstsprache ist, gehört zu den Fällen, in denen sich das laute Üben am stärksten lohnt.
Brauche ich eine eigene Rollenspiel-Plattform, wenn ich schon einen Live-Assistenten im Gespräch habe?
Es hängt davon ab, ob Sie eine belastbare Bewertung brauchen. Mit CallPrompter bekommen Sie die Übung und das echte Gespräch auf demselben Satz Skripte, dazu das Transkript und die Wiedergabe der Sitzung, und Sie bekommen keine Benotung, keinen Zertifizierungspfad und keinen Manager-Report zur Übung. Teams, die zertifizieren oder Kohorten vergleichen müssen, brauchen eine Plattform, die für das Bewerten gebaut ist. Teams, die wollen, dass ihre Leute genau das Material proben, das im Gespräch erscheinen wird, meistens nicht.
Was geschieht mit Aufnahme und Transkript nach einer Übungssitzung oder einem Live-Gespräch, und wo liegen sie?
CallPrompter behält keine Audiodatei, sobald eine Übungssitzung oder ein Live-Gespräch endet, und mit Audio oder Transkripten von Kundinnen und Kunden wird kein Modell trainiert. Das Transkript und seine Auswertung bleiben auf Servern in der Schweiz in Ihrem Konto, bis Sie sie löschen, und wenn Sie das Konto löschen, werden alle seine Daten innert 30 Tagen endgültig gelöscht. Die Transkription in Echtzeit verarbeitet ein Anbieter mit Sitz in den Vereinigten Staaten, Audio verlässt die Schweiz also, solange die Sitzung läuft.
Machen Sie den Test, auch mit uns
Nehmen Sie zwei oder drei Produkte, schreiben Sie ein Szenario mit einer verdeckten Agenda, und geben Sie jedem dieselbe Stunde und dieselben provozierenden Eingaben. Bewerten Sie sie über die sieben Punkte. Das Werkzeug, das den Eigenwillen des Käufers und die Aussagekraft der Bewertung übersteht, ist das eine Bestellung wert, was auch immer auf seiner Funktionsliste steht.
Wenn Sie das gegen unseren Übungsmodus fahren wollen: Die kostenlose Testversion von CallPrompter gibt Ihnen 30 Minuten KI-Übung über sieben Tage, ohne Kreditkarte. Das Live-Coaching im Gespräch ist kostenpflichtig und nicht Teil der Testversion. Was diese 30 Minuten zeigen, ist der Teil, der uns am meisten bedeutet. Das Prompter-Overlay läuft während der Übung neben Ihrem Fenster genauso, wie es während eines echten Gesprächs läuft, auf demselben Skript und derselben Einwand-Bibliothek. Die nächste Frage und die Antwort auf den eben gehörten Einwand erscheinen beim Üben an derselben Stelle wie im Gespräch selbst. Wie eine einzelne Sitzung von innen abläuft, beschreiben wir Schritt für Schritt auf einer eigenen Seite. Wenn Sie das Protokoll lieber gemeinsam durchgehen, buchen Sie ein Gespräch.
Weitere Artikel
So schreiben Sie eine Buyer Persona, die eine KI im Rollenspiel wirklich spielen kann
Einwände in der Kaltakquise: die 12 häufigsten und was Sie darauf antworten